
Transformers documentation
PoolFormer
Este modelo se publicó en HF papers el 22-11-2021 y se contribuyó a Hugging Face Transformers el 17-02-2022.
PoolFormer
Resumen
El modelo PoolFormer fue propuesto en MetaFormer is Actually What You Need for Vision por Sea AI Labs. En lugar de diseñar un mezclador de tokens complicado para lograr un rendimiento SOTA, el objetivo de este trabajo es demostrar que la competencia de los modelos transformer proviene en gran medida de la arquitectura general MetaFormer.
El resumen del artículo es el siguiente:
Los Transformers han demostrado un gran potencial en tareas de visión por computadora. Se cree comúnmente que su módulo de mezcla de tokens basado en atención contribuye más a su competencia. Sin embargo, trabajos recientes muestran que el módulo basado en atención en los Transformers puede ser reemplazado por MLPs espaciales y que los modelos resultantes aún rinden bastante bien. Basándonos en esta observación, hipotetizamos que la arquitectura general de los Transformers, en lugar del módulo específico de mezcla de tokens, es más esencial para el rendimiento del modelo. Para verificar esto, reemplazamos deliberadamente el módulo de atención en los Transformers con un operador de agrupación espacial (spatial pooling) sorprendentemente simple para realizar solo la mezcla de tokens más básica. Sorprendentemente, observamos que el modelo derivado, denominado PoolFormer, logra un rendimiento competitivo en múltiples tareas de visión por computadora. Por ejemplo, en ImageNet-1K, PoolFormer alcanza una precisión top-1 del 82,1 %, superando a las líneas base bien ajustadas similares a vision transformer/MLP, DeiT-B/ResMLP-B24, en 0,3 %/1,1 % de precisión, con 35 %/52 % menos parámetros y 48 %/60 % menos MACs. La efectividad de PoolFormer verifica nuestra hipótesis y nos urge a iniciar el concepto de “MetaFormer”, una arquitectura general abstraída de los Transformers sin especificar el mezclador de tokens. Basándonos en los extensos experimentos, argumentamos que MetaFormer es el actor clave para lograr resultados superiores en los modelos recientes similares a Transformers y MLP en tareas de visión. Este trabajo llama a más investigación futura dedicada a mejorar MetaFormer en lugar de centrarse en los módulos de mezcla de tokens. Además, nuestro PoolFormer propuesto podría servir como línea base inicial para el diseño futuro de arquitecturas MetaFormer.
La figura siguiente ilustra la arquitectura de PoolFormer. Tomada del artículo original.
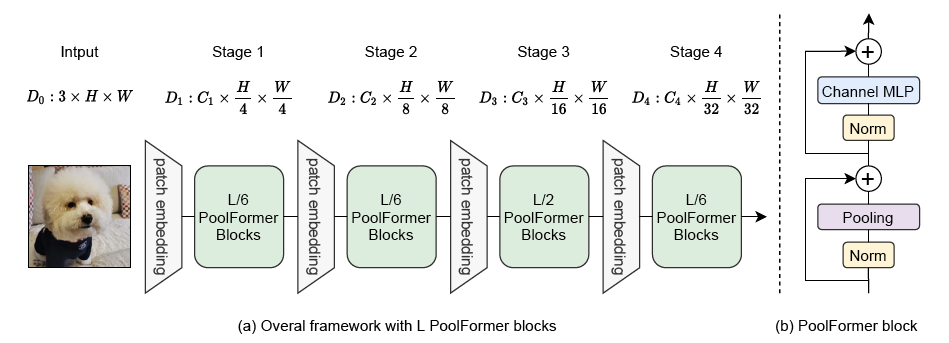
Este modelo fue aportado por heytanay. El código original se puede encontrar aquí.
Consejos de uso
- PoolFormer tiene una arquitectura jerárquica, donde en lugar de Attention, hay una capa simple de Average Pooling. Todos los checkpoints del modelo se pueden encontrar en el hub.
- Se puede usar PoolFormerImageProcessor para preparar las imágenes para el modelo.
- Como la mayoría de los modelos, PoolFormer está disponible en diferentes tamaños, cuyos detalles se pueden encontrar en la tabla siguiente.
| Variante del modelo | Profundidades | Tamaños ocultos | Parámetros (M) | ImageNet-1k Top 1 |
|---|---|---|---|---|
| s12 | [2, 2, 6, 2] | [64, 128, 320, 512] | 12 | 77.2 |
| s24 | [4, 4, 12, 4] | [64, 128, 320, 512] | 21 | 80.3 |
| s36 | [6, 6, 18, 6] | [64, 128, 320, 512] | 31 | 81.4 |
| m36 | [6, 6, 18, 6] | [96, 192, 384, 768] | 56 | 82.1 |
| m48 | [8, 8, 24, 8] | [96, 192, 384, 768] | 73 | 82.5 |
Recursos
Una lista de recursos oficiales de Hugging Face y de la comunidad (indicados por 🌎) para ayudarte a empezar con PoolFormer.
- PoolFormerForImageClassification es compatible con este cuaderno.
- Véase también: Guía de la tarea de clasificación de imágenes
Si te interesa enviar un recurso para que se incluya aquí, no dudes en abrir una Pull Request y lo revisaremos. Lo ideal es que el recurso demuestre algo nuevo en lugar de duplicar un recurso existente.
PoolFormerConfig
clase transformers.PoolFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonenum_channels: int = 3patch_size: int | list[int] | tuple[int, int] = 16stride: int = 16pool_size: int = 3mlp_ratio: float = 4.0depths: list[int] | tuple[int, ...] = (2, 2, 6, 2)hidden_sizes: list[int] | tuple[int, ...] = (64, 128, 320, 512)patch_sizes: list[int] | tuple[int, ...] = (7, 3, 3, 3)strides: list[int] | tuple[int, ...] = (4, 2, 2, 2)padding: list[int] | tuple[int, ...] = (2, 1, 1, 1)num_encoder_blocks: int = 4drop_path_rate: float | int = 0.0hidden_act: str = 'gelu'use_layer_scale: bool = Truelayer_scale_init_value: float = 1e-05initializer_range: float = 0.02 )
Parámetros
- num_channels (
int, opcional, valor predeterminado3) — El número de canales de entrada. - patch_size (
Union[int, list[int], tuple[int, int]], opcional, valor predeterminado16) — El tamaño (resolución) de cada parche. - stride (
int, opcional, valor predeterminado 16) — El paso del parche de entrada. - pool_size (
int, opcional, valor predeterminado 3) — El tamaño de la ventana de agrupación. - mlp_ratio (
float, opcional, valor predeterminado4.0) — Relación entre la dimensión oculta del MLP y la dimensión de la incrustación. - depths (
Union[list[int], tuple[int, ...]], opcional, valor predeterminado(2, 2, 6, 2)) — Profundidad de cada capa en el Transformer. - hidden_sizes (
Union[list[int], tuple[int, ...]], opcional, valor predeterminado(64, 128, 320, 512)) — Dimensionalidad (tamaño oculto) en cada etapa del modelo. - patch_sizes (
list, opcional, valor predeterminado[7, 3, 3, 3]) — El tamaño del parche de entrada para cada bloque del codificador. - strides (
list, opcional, valor predeterminado[4, 2, 2, 2]) — El desplazamiento del parche de entrada para cada bloque del codificador. - padding (
list, opcional, valor predeterminado[2, 1, 1, 1]) — El relleno del parche de entrada para cada bloque codificador. - num_encoder_blocks (
int, opcional, valor predeterminado 4) — El número de bloques del codificador. - drop_path_rate (
Union[float, int], opcional, valor predeterminado0.0) — Tasa de drop path para la fusión de parches. - hidden_act (
str, opcional, valor predeterminadogelu) — La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo,"gelu","relu","silu", etc. - use_layer_scale (
bool, opcional, valor predeterminadoTrue) — Si se debe usar layer scale. - layer_scale_init_value (
float, opcional, valor predeterminado1e-05) — Escala a utilizar en las capas de autoatención. 0.1 para base, 1e-6 para grande. Establezca 0 para deshabilitar la escala de capa. - initializer_range (
float, opcional, valor predeterminado0.02) — La desviación estándar del truncated_normal_initializer para inicializar todas las matrices de pesos.
Esta es la clase de configuración para almacenar la configuración de un PoolFormerModel. Se utiliza para instanciar un modelo Poolformer según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de sail/poolformer_s12
Los objetos de configuración heredan de PreTrainedConfig y se pueden usar para controlar las salidas del modelo. Lea la documentación de PreTrainedConfig para obtener más información.
Ejemplo:
>>> from transformers import PoolFormerConfig, PoolFormerModel

>>> # Initializing a PoolFormer sail/poolformer_s12 style configuration
>>> configuration = PoolFormerConfig()

>>> # Initializing a model (with random weights) from the sail/poolformer_s12 style configuration
>>> model = PoolFormerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
PoolFormerImageProcessor
clase transformers.PoolFormerImageProcessor
< source >( **kwargs: *<class 'transformers.models.poolformer.image_processing_poolformer.PoolFormerImageProcessorKwargs'> )
Parámetros
- do_convert_rgb (
bool, kwargs, opcional, valor predeterminadoNone) — Si se debe convertir la imagen a RGB. - do_resize (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe redimensionar la imagen. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, por defecto{'shortest_edge' -- 224}): Describe las dimensiones máximas de entrada para el modelo. - default_to_square (
bool, kwargs, opcional, valor predeterminadoFalse) — Si se debe usar una imagen cuadrada por defecto al redimensionar, si size es un int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, por defecto{'height' -- 224, 'width': 224}): Tamaño de la imagen de salida tras aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, por defecto3) — Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los valores de la enumeraciónPILImageResampling. Solo tiene efecto sido_resizeestá establecido enTrue. - do_rescale (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe reescalar la imagen. - rescale_factor (
float, kwargs, opcional, valor predeterminado0.00392156862745098) — Factor de reescalado para reescalar la imagen sido_rescaleestá establecido enTrue. - do_normalize (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe normalizar la imagen. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, valor predeterminado[0.485, 0.456, 0.406]) — Media de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, valor predeterminado[0.229, 0.224, 0.225]) — Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - do_pad (
bool, kwargs, opcional) — Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — El tamaño en{"height": int, "width" int}al que se rellenan las imágenes. Debe ser mayor que cualquier tamaño de imagen proporcionado para el preprocesamiento. Si no se proporcionapad_size, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuandodo_pad=True. - do_center_crop (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe recortar la imagen centrada. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — Solo se admiteChannelDimension.FIRST. Se añadió para garantizar la compatibilidad con los procesadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — El formato de la dimensión de canales para la imagen de entrada. Si no se establece, el formato de la dimensión de canales se infiere a partir de la imagen de entrada. Puede ser uno de:"channels_first"oChannelDimension.FIRST: imagen en formato (num_channels, height, width)."channels_last"oChannelDimension.LAST: imagen en formato (altura, ancho, num_canales)."none"oChannelDimension.NONE: imagen en formato (altura, ancho).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — El dispositivo en el que se procesarán los videos. Si no se establece, el dispositivo se infiere a partir de los videos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Devuelve tensores apilados si se establece en'pt'; en caso contrario, devuelve una lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Añadido por compatibilidad con versiones anteriores, pero en futuros modelos debería establecerse como un atributo del procesador. - crop_pct (
float, kwargs, opcional, valor predeterminadoself.crop_pct) — Porcentaje de la imagen que se recortará. Solo tiene efecto sido_resizeestá establecido enTrue.
Construye un procesador de imágenes PoolFormerImageProcessor.
preprocesar
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
Parámetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezcado_rescale=False. - image_like_kwargs (
dict[str, Any], opcional) — Bandera para desarrolladores destinada a entradas adicionales de tipo imagen que también se preprocesarán. Utilice esto solo si pasar las entradas como kwarg no funciona. Por ejemplo,preprocess(images, masks=masks)es la opción preferida, pero provoca problemas de prioridad de argumentos en algunos modelos. En esos casos se puede usarpreprocess(images, image_like_inputs={"masks": masks})en su lugar. - do_convert_rgb (
bool, kwargs, opcional) — Si se debe convertir la imagen a RGB. - do_resize (
bool, kwargs, opcional) — Si se debe redimensionar la imagen. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Describe las dimensiones de entrada máximas del modelo. - default_to_square (
bool, kwargs, opcional) — Si se debe usar una imagen cuadrada por defecto al redimensionar, si size es un int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamaño de la imagen de salida tras aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los enumPILImageResampling. Solo tiene efecto sido_resizeestá establecido enTrue. - do_rescale (
bool, kwargs, opcional) — Si se debe reescalar la imagen. - rescale_factor (
float, kwargs, opcional) — Factor de reescalado para reescalar la imagen sido_rescaleestá establecido enTrue. - do_normalize (
bool, kwargs, opcional) — Si se debe normalizar la imagen. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Media de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - do_pad (
bool, kwargs, opcional) — Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — El tamaño en{"height": int, "width" int}al que se rellenan las imágenes. Debe ser mayor que cualquier tamaño de imagen proporcionado para el preprocesamiento. Si no se proporcionapad_size, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Si se debe recortar la imagen centrada. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — Solo se admiteChannelDimension.FIRST. Se añadió para garantizar la compatibilidad con los procesadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — El formato de la dimensión de canales para la imagen de entrada. Si no se establece, el formato de la dimensión de canales se infiere a partir de la imagen de entrada. Puede ser uno de:"channels_first"oChannelDimension.FIRST: imagen en formato (num_channels, height, width)."channels_last"oChannelDimension.LAST: imagen en formato (altura, ancho, num_canales)."none"oChannelDimension.NONE: imagen en formato (altura, ancho).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — El dispositivo en el que se procesarán los videos. Si no se establece, el dispositivo se infiere a partir de los videos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Devuelve tensores apilados si se establece en'pt'; en caso contrario, devuelve una lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Añadido por compatibilidad con versiones anteriores, pero en futuros modelos debería establecerse como un atributo del procesador.
Devuelve
~image_processing_base.BatchFeature
- data (
dict) — Diccionario de listas/arrays/tensores devueltos por el método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
Preprocesa una imagen o un lote de imágenes.
PoolFormerImageProcessorPil
clase transformers.PoolFormerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.poolformer.image_processing_pil_poolformer.PoolFormerImageProcessorKwargs'> )
Parámetros
- do_convert_rgb (
bool, kwargs, opcional, valor predeterminadoNone) — Si se debe convertir la imagen a RGB. - do_resize (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe redimensionar la imagen. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, por defecto{'shortest_edge' -- 224}): Describe las dimensiones máximas de entrada para el modelo. - default_to_square (
bool, kwargs, opcional, valor predeterminadoFalse) — Si se debe usar una imagen cuadrada por defecto al redimensionar, si size es un int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, por defecto{'height' -- 224, 'width': 224}): Tamaño de la imagen de salida tras aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, por defecto3) — Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los valores de la enumeraciónPILImageResampling. Solo tiene efecto sido_resizeestá establecido enTrue. - do_rescale (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe reescalar la imagen. - rescale_factor (
float, kwargs, opcional, valor predeterminado0.00392156862745098) — Factor de reescalado para reescalar la imagen sido_rescaleestá establecido enTrue. - do_normalize (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe normalizar la imagen. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, valor predeterminado[0.485, 0.456, 0.406]) — Media de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, valor predeterminado[0.229, 0.224, 0.225]) — Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - do_pad (
bool, kwargs, opcional) — Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — El tamaño en{"height": int, "width" int}al que se rellenan las imágenes. Debe ser mayor que cualquier tamaño de imagen proporcionado para el preprocesamiento. Si no se proporcionapad_size, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuandodo_pad=True. - do_center_crop (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe recortar la imagen centrada. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — Solo se admiteChannelDimension.FIRST. Se añadió para garantizar la compatibilidad con los procesadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — El formato de la dimensión de canales para la imagen de entrada. Si no se establece, el formato de la dimensión de canales se infiere a partir de la imagen de entrada. Puede ser uno de:"channels_first"oChannelDimension.FIRST: imagen en formato (num_channels, height, width)."channels_last"oChannelDimension.LAST: imagen en formato (altura, ancho, num_canales)."none"oChannelDimension.NONE: imagen en formato (altura, ancho).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — El dispositivo en el que se procesarán los videos. Si no se establece, el dispositivo se infiere a partir de los videos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Devuelve tensores apilados si se establece en'pt'; en caso contrario, devuelve una lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Añadido por compatibilidad con versiones anteriores, pero en futuros modelos debería establecerse como un atributo del procesador. - crop_pct (
float, kwargs, opcional, valor predeterminadoself.crop_pct) — Porcentaje de la imagen que se recortará. Solo tiene efecto sido_resizeestá establecido enTrue.
Construye un procesador de imágenes PoolFormerImageProcessor.
preprocesar
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
Parámetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezcado_rescale=False. - image_like_kwargs (
dict[str, Any], opcional) — Bandera para desarrolladores destinada a entradas adicionales de tipo imagen que también se preprocesarán. Utilice esto solo si pasar las entradas como kwarg no funciona. Por ejemplo,preprocess(images, masks=masks)es la opción preferida, pero provoca problemas de prioridad de argumentos en algunos modelos. En esos casos se puede usarpreprocess(images, image_like_inputs={"masks": masks})en su lugar. - do_convert_rgb (
bool, kwargs, opcional) — Si se debe convertir la imagen a RGB. - do_resize (
bool, kwargs, opcional) — Si se debe redimensionar la imagen. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Describe las dimensiones de entrada máximas del modelo. - default_to_square (
bool, kwargs, opcional) — Si se debe usar una imagen cuadrada por defecto al redimensionar, si size es un int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamaño de la imagen de salida tras aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los enumPILImageResampling. Solo tiene efecto sido_resizeestá establecido enTrue. - do_rescale (
bool, kwargs, opcional) — Si se debe reescalar la imagen. - rescale_factor (
float, kwargs, opcional) — Factor de reescalado para reescalar la imagen sido_rescaleestá establecido enTrue. - do_normalize (
bool, kwargs, opcional) — Si se debe normalizar la imagen. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Media de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - do_pad (
bool, kwargs, opcional) — Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — El tamaño en{"height": int, "width" int}al que se rellenan las imágenes. Debe ser mayor que cualquier tamaño de imagen proporcionado para el preprocesamiento. Si no se proporcionapad_size, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Si se debe recortar la imagen centrada. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — Solo se admiteChannelDimension.FIRST. Se añadió para garantizar la compatibilidad con los procesadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — El formato de la dimensión de canales para la imagen de entrada. Si no se establece, el formato de la dimensión de canales se infiere a partir de la imagen de entrada. Puede ser uno de:"channels_first"oChannelDimension.FIRST: imagen en formato (num_channels, height, width)."channels_last"oChannelDimension.LAST: imagen en formato (altura, ancho, num_canales)."none"oChannelDimension.NONE: imagen en formato (altura, ancho).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — El dispositivo en el que se procesarán los videos. Si no se establece, el dispositivo se infiere a partir de los videos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Devuelve tensores apilados si se establece en'pt'; en caso contrario, devuelve una lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Añadido por compatibilidad con versiones anteriores, pero en futuros modelos debería establecerse como un atributo del procesador.
Devuelve
~image_processing_base.BatchFeature
- data (
dict) — Diccionario de listas/arrays/tensores devueltos por el método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
Preprocesa una imagen o un lote de imágenes.
PoolFormerModel
clase transformers.PoolFormerModel
< source >( config: PoolFormerConfig )
Parámetros
- config (PoolFormerConfig) — Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método from_pretrained() para cargar los pesos del modelo.
El modelo Poolformer básico que emite estados ocultos sin ningún cabezal específico en la parte superior.
Este modelo hereda de PreTrainedModel. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de torch.nn.Module de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
forward
< source >( pixel_values: typing.Optional[torch.FloatTensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithNoAttention or tuple(torch.FloatTensor)
Parámetros
- pixel_values (
torch.FloatTensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener utilizando PoolFormerImageProcessor. Consulte PoolFormerImageProcessor.call() para más detalles (processor_classutiliza PoolFormerImageProcessor para procesar las imágenes). - output_hidden_states (
bool, opcional) — Indica si se deben devolver los estados ocultos de todas las capas. Consultehidden_statesen los tensores devueltos para obtener más detalles. - return_dict (
bool, opcional) — Indica si se debe devolver un ModelOutput en lugar de una tupla simple.
Devuelve
BaseModelOutputWithNoAttention o tuple(torch.FloatTensor)
Un BaseModelOutputWithNoAttention o una tupla de
torch.FloatTensor (si se pasa return_dict=False o cuando config.return_dict=False) que comprende varios
elementos según la configuración (PoolFormerConfig) y las entradas.
El método forward de PoolFormerModel reemplaza el método especial __call__.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de
Moduledespués en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de pre y postprocesamiento, mientras que la segunda los ignora silenciosamente.
last_hidden_state (
torch.FloatTensorde forma(batch_size, num_channels, height, width)) — Secuencia de estados ocultos en la salida de la última capa del modelo.hidden_states (
tuple(torch.FloatTensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.FloatTensor(una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma(batch_size, num_channels, height, width).Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
PoolFormerForImageClassification
clase transformers.PoolFormerForImageClassification
< source >( config: PoolFormerConfig )
Parámetros
- config (PoolFormerConfig) — Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método from_pretrained() para cargar los pesos del modelo.
PoolFormer Modelo transformer con una cabeza de clasificación de imágenes
Este modelo hereda de PreTrainedModel. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de torch.nn.Module de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
forward
< source >( pixel_values: typing.Optional[torch.FloatTensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → ImageClassifierOutputWithNoAttention or tuple(torch.FloatTensor)
Parámetros
- pixel_values (
torch.FloatTensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener utilizando PoolFormerImageProcessor. Consulte PoolFormerImageProcessor.call() para más detalles (processor_classutiliza PoolFormerImageProcessor para procesar las imágenes). - labels (
torch.LongTensorde forma(batch_size,), opcional) — Etiquetas para calcular la pérdida de clasificación/regresión de imágenes. Los índices deben estar en[0, ..., config.num_labels - 1]. Siconfig.num_labels == 1se calcula una pérdida de regresión (pérdida de error cuadrático medio), siconfig.num_labels > 1se calcula una pérdida de clasificación (entropía cruzada). - output_hidden_states (
bool, opcional) — Indica si se deben devolver los estados ocultos de todas las capas. Consultehidden_statesen los tensores devueltos para obtener más detalles. - return_dict (
bool, opcional) — Indica si se debe devolver un ModelOutput en lugar de una tupla simple.
Devuelve
ImageClassifierOutputWithNoAttention o tuple(torch.FloatTensor)
Un ImageClassifierOutputWithNoAttention o una tupla de
torch.FloatTensor (si se pasa return_dict=False o cuando config.return_dict=False) que comprende varios
elementos según la configuración (PoolFormerConfig) y las entradas.
El método forward de PoolFormerForImageClassification sobrescribe el método especial __call__.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de
Moduledespués en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de pre y postprocesamiento, mientras que la segunda los ignora silenciosamente.
- loss (
torch.FloatTensorde forma(1,), opcional, devuelta cuando se proporcionalabels) — Pérdida de clasificación (o de regresión si config.num_labels==1). - logits (
torch.FloatTensorde forma(batch_size, config.num_labels)) — Puntuaciones de clasificación (o de regresión si config.num_labels==1) (antes de SoftMax). - hidden_states (
tuple(torch.FloatTensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.FloatTensor(una para la salida de las incrustaciones, si el modelo tiene una capa de incrustación, + una para la salida de cada etapa) de forma(batch_size, num_channels, height, width). Estados ocultos (también llamados mapas de características) del modelo en la salida de cada etapa.
Ejemplo:
>>> from transformers import AutoImageProcessor, PoolFormerForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("sail/poolformer_s12")
>>> model = PoolFormerForImageClassification.from_pretrained("sail/poolformer_s12")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...