Hugging Face
Models
Datasets
Spaces
Buckets
new
Docs
Enterprise
Pricing
Website
Tasks
HuggingChat
Collections
Languages
Organizations
Community
Blog
Posts
Daily Papers
Hardware
Learn
Discord
Forum
GitHub
Solutions
Team & Enterprise
Hugging Face PRO
Enterprise Support
Inference Providers
Inference Endpoints
Storage Buckets
Log In
Sign Up
Seungone Kim
PRO
seungone
16
52
82
Follow
Seongyun's profile picture
jeffrobot's profile picture
dark-pen's profile picture
35 followers
·
24 following
https://seungonekim.github.io/
seungonekim
SeungoneKim
AI & ML interests
Large Language Models, LLM-as-a-Judge, Reward Model Overoptimization, Personalized Alignment
Recent Activity
liked
a dataset
about 4 hours ago
ScholarCatalyst/ScholarCatalyst
upvoted
a
paper
1 day ago
Sharpening Tax in Post-Training
upvoted
a
paper
about 1 month ago
DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
View all activity
Organizations
Papers
43
arxiv:
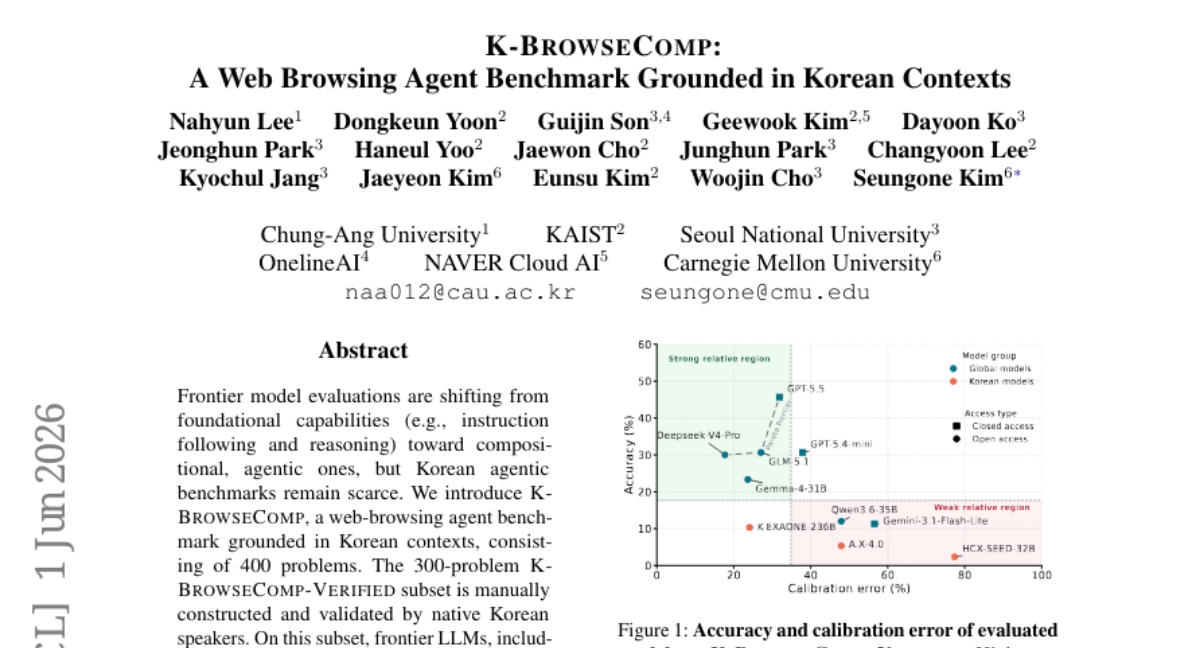
2606.02404
arxiv:
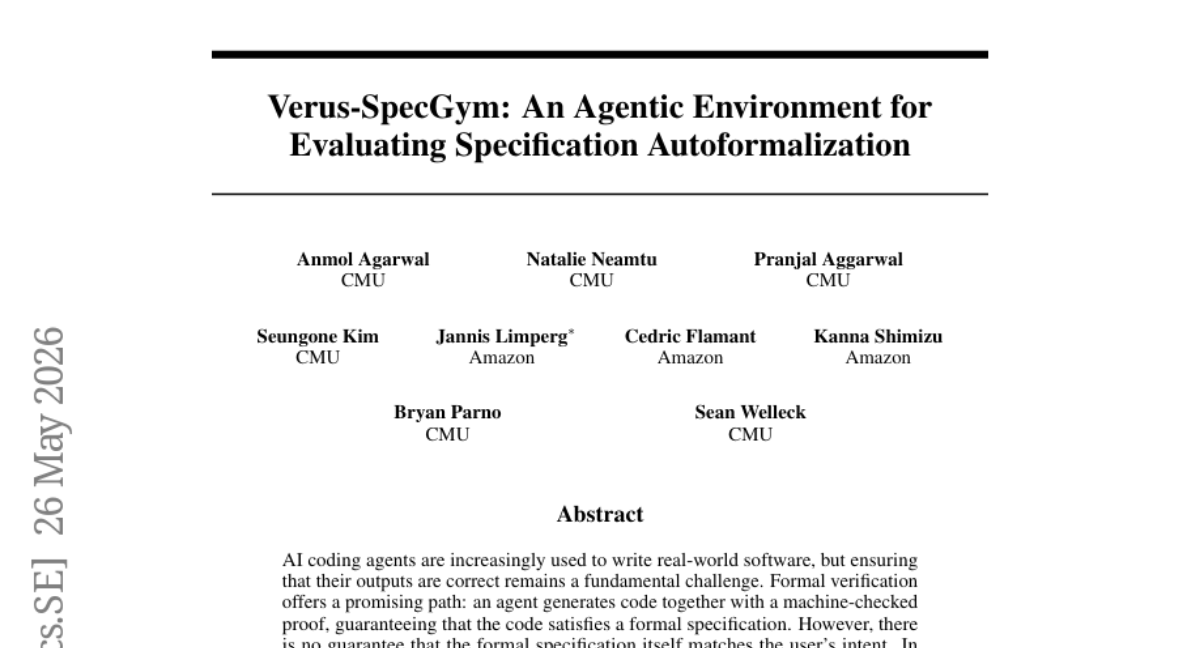
2605.26457
arxiv:
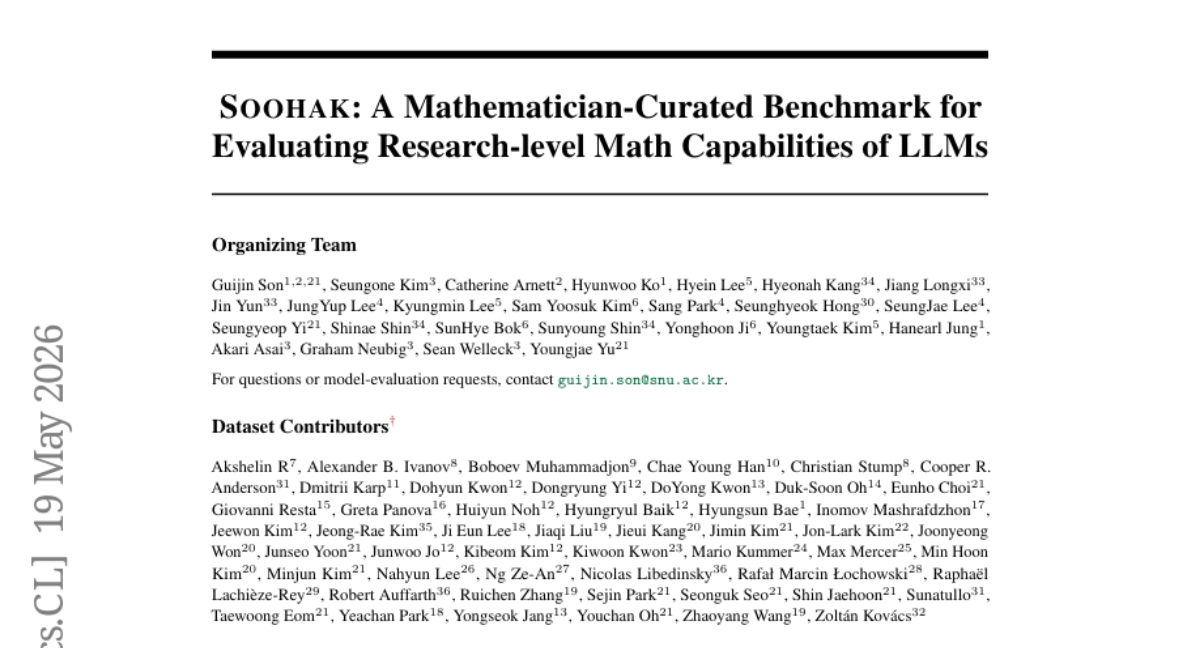
2605.20668
arxiv:
2605.09063
View 43 papers
spaces
2
Sort: Recently updated
pinned
Running
My Argilla
✍
Runtime error
Test3
🟧
models
1
seungone/skywork-reward-replicate
Text Classification
•
8B
•
Updated
Dec 11, 2024
•
11
datasets
5
Sort: Recently updated
seungone/ablation1_math_gpt4o_mini
Viewer
•
Updated
Nov 25, 2024
•
5.56k
•
13
seungone/ablation3_math_llama3.1_8b_instruct
Viewer
•
Updated
Nov 25, 2024
•
24.8k
•
29
seungone/ablation2_math_llama3.1_8b_instruct
Viewer
•
Updated
Nov 25, 2024
•
5.99k
•
13
seungone/ablation1_code_gpt4o_mini
Viewer
•
Updated
Nov 25, 2024
•
10k
•
26
seungone/final-math-claude3.5_sonnet-10000
Viewer
•
Updated
Sep 16, 2024
•
10k
•
25
•
1