
TRL documentation
TRL - Transformers による強化学習

TRL - Transformers による強化学習
TRLはフルスタックのライブラリであり、Supervised Fine-Tuning (SFT)、Group Relative Policy Optimization (GRPO)、Direct Preference Optimization (DPO)、Reward Modelingなどの手法を用いてtransformer言語モデルを訓練するためのツールセットを提供しています。 このライブラリは🤗 transformersと統合されています。
🎉 新着情報
🔥 Mistral Large 4: Mistral Large 4を、FP8重みの基盤として、8つのB300からなる単一ノード上でSFTTrainerを用いてファインチューニングします。LoRAの例を参照してください。
🚀 AMD GPUでのトレーニング: TRLのトレーナーは、PyTorchのROCmビルドを通じて、AMD Instinct GPU上で実行できるようになりました。
🔥 Beam: 8つのB300で構成される単一ノード上で、SFTTrainerを使用してBeamをファインチューニングします。LoRAの例を参照してください。
🔥 Muse Spark Open: Muse Spark OpenをSFTTrainerでファインチューニングし、ロード時にGPU間でシャード化します。8ノードのLoRAの例をご覧ください。
🚀 AWS Trainiumでのトレーニング: TRLのトレーナーは、PyTorchのネイティブNeuronバックエンドであるTorchNeuronを通じて、AWS Trainium上で実行できるようになりました。
分類
以下は、TRLのトレーナーを成熟度と手法の種類別に整理した概要です。
実験的
TRL Hugging Face organizationで、TRL関連のモデル、データセット、デモも探索できます。
学習
🤗 smol courseで、TRLやその他のライブラリを使ったポストトレーニングを学びましょう。
目次
ドキュメントは以下のセクションに構成されています:
- はじめる: インストールとクイックスタートガイド。
- コンセプトガイド: データセットの形式、学習に関する FAQ、ログの理解。
- ハウツーガイド: メモリ使用量の削減、トレーニングの高速化、トレーニングの分散化など
- 統合: DeepSpeed、PEFT など
- 例: 例の概要、コミュニティのチュートリアルなど。
- API:トレーナー、ユーティリティなど
ブログ記事
2026年5月27日に公開
Hub バケットで 1 兆パラメータを配信する:TRL における Delta Weight Sync

2026年3月31日に公開
TRL v1: 分野が自らの前提を無効化する状況でも通用するポストトレーニングライブラリ
2026年3月10日に公開
トークンを止めない: 16のオープンソースRLライブラリから得た教訓
2026年3月9日に公開
Ulysses シーケンス並列性: 百万トークンコンテキストでの学習
2025年10月23日公開
オープンエージェントエコシステムを共に構築する:OpenEnvの紹介
2025年8月7日に公開
TRLにおけるビジョン言語モデルのアライメント ⚡️
2025年6月3日に公開
NO GPU left behind: TRLにおけるCo-located vLLMによる効率性の解放
2025年5月25日に公開
🐯 Liger GRPOとTRLの出会い
2025年1月28日に公開
Open-R1: DeepSeek-R1の完全なオープン再現
2024年7月10日に公開
TRLによるビジョン言語モデルのPreference Optimization
2024年6月12日に公開
RLHFにRLを取り戻す
2024年1月10日に公開
Unslothと🤗 TRLでLLMのファインチューニングを2倍速く
2023年9月29日に公開
TRLによるDDPOでStable Diffusionモデルのファインチューニング
2023年8月8日に公開
DPOでLlama 2をファインチューニング
2023年4月5日に公開
StackLLaMA: RLHFでLLaMAを学習するための実践ガイド
2023年3月9日に公開
24GBのコンシューマー向けGPUでRLHFを用いて20BのLLMをファインチューニング
2022年12月9日に公開
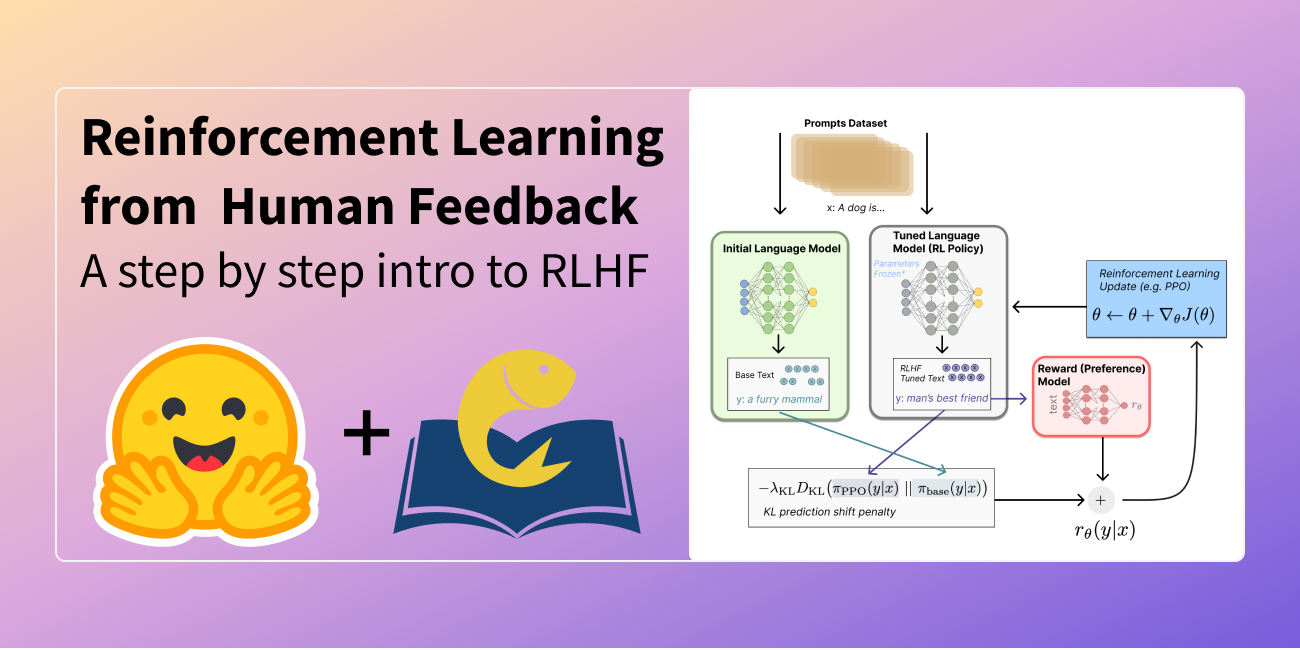
人間のフィードバックによる強化学習の図解
